表维护包含一系列操作,用于保持 Apache Iceberg 表随时间推移的性能和成本效率。随着数据的写入、更新和删除,表会累积可能影响查询性能的元数据和文件。
Basin Catalog 自动化两项关键维护操作:
- 压缩:将小型数据文件合并为更大、更高效的文件,以提高查询性能
- 快照过期:删除旧表快照及任何未引用的数据文件,以减少元数据开销和存储成本
如果不进行定期维护,表可能会遇到以下问题:
- 查询性能下降:需要扫描的文件越多,查询越慢,计算成本越高
- 存储成本增加:小文件和旧快照的累积消耗不必要的存储空间
- 元数据开销:大型元数据文件会减慢查询规划和表操作
通过启用自动表维护,Basin Catalog 确保您的表保持优化,而无需手动运行维护操作。
每个表的 Maintenance(维护) 选项卡显示压缩和快照过期的配置、计划以及下次符合条件的时间。它还提供分页的维护运行历史,包含状态和持续时间。
-
在 Cloudflare 仪表板中,前往 Basin Catalog。
前往 Basin Catalog ↗ -
选择一个 catalog,然后选择 Explorer 选项卡。Explorer 选项卡默认打开。
-
选择一张表。
-
选择 Maintenance(维护) 选项卡。
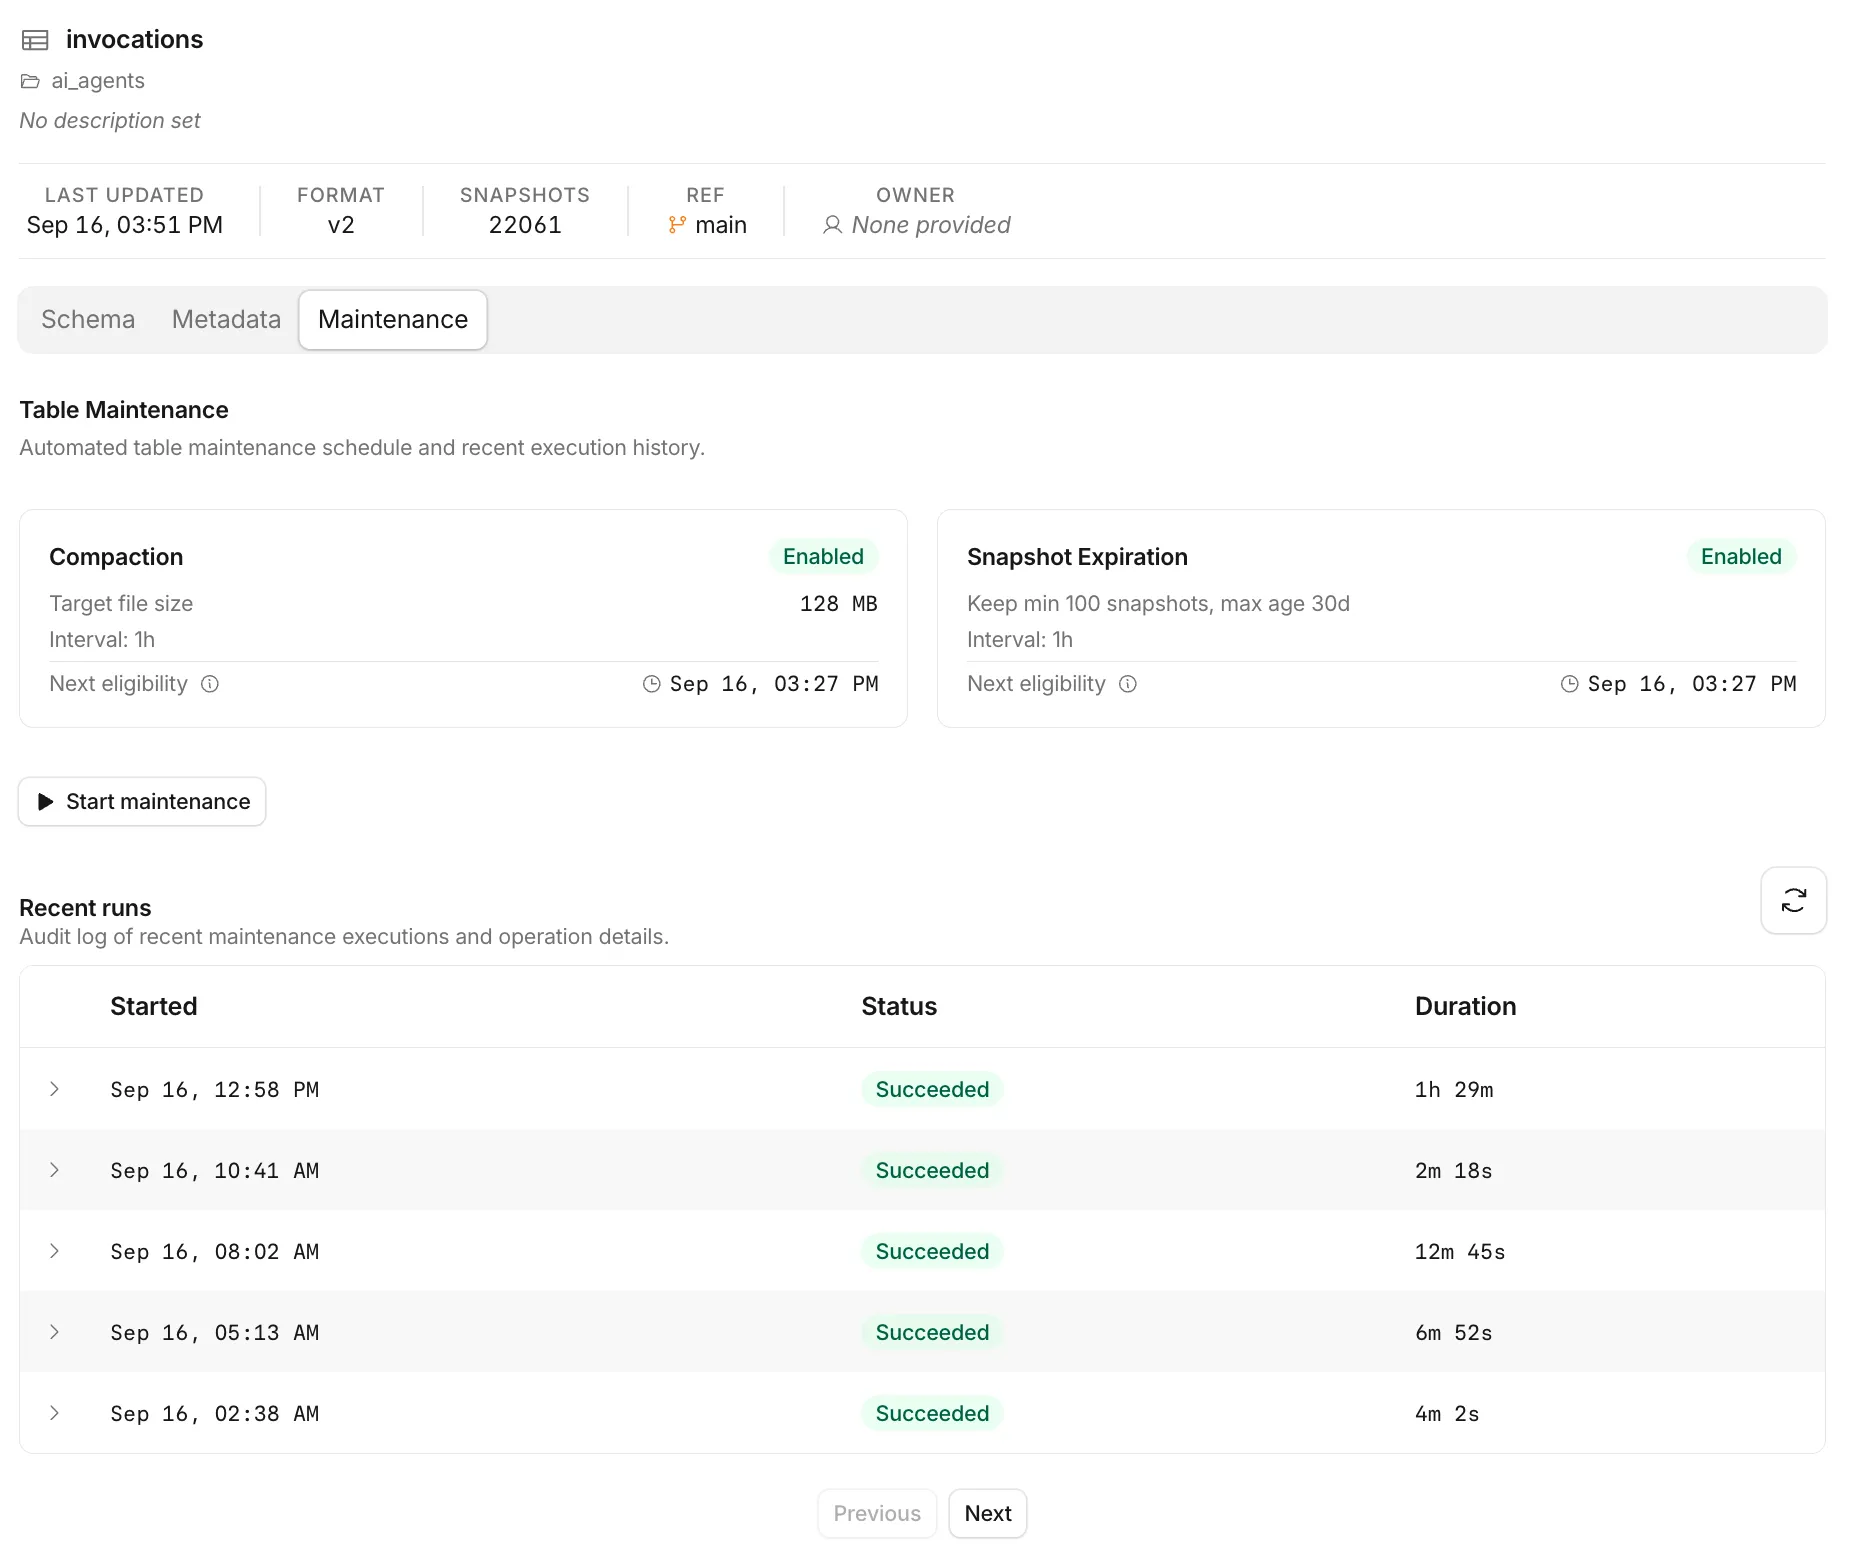
Recent runs(近期运行) 部分每页显示五次运行。展开一次运行可查看其 manifest 重写、压缩和快照过期操作的指标。对于手动排队的运行,展开的详情包含可搜索的 request_id。
手动排队会为所选表请求压缩。该请求进入与自动维护相同的队列,并在调度器下次轮询符合条件的工作时启动。
- 在表的 Maintenance(维护) 选项卡中,选择 Queue maintenance(排队维护)。
- 在确认对话框中,选择 Queue maintenance(排队维护)。
仪表板在接受请求前会检查您的权限。排队也可能返回以下错误:
40903:维护执行器冲突,导致请求无法排队。42901:已达到每日接受请求上限。
Apache Iceberg ↗ 中的每次写入操作,无论大小,都会产生一系列新文件。随着时间推移,文件数量可能无限增长。这可能导致:
- 查询变慢和 I/O 操作增加:没有压缩,查询引擎必须打开并读取每个单独的文件,导致查询时间更长、成本更高。
- 元数据开销增加:查询引擎必须扫描元数据文件以确定要读取哪些文件。当有数千个小文件时,在访问数据之前查询规划就需要更长时间。
- 压缩效率降低:小文件的压缩效率低于大文件,导致存储成本更高,查询期间需要传输更多数据。
Basin Catalog 现在可以管理存储在 R2 中的 Apache Iceberg 表的压缩。启用后,压缩会自动运行,合并尚未压缩的新文件。
压缩后的文件在各自表的 /data/ 目录中以 compacted- 为前缀。
启用 catalog 级压缩:
npx wrangler basin catalog compaction enable my-bucket --target-size 128 --token $R2_CATALOG_TOKENyarn wrangler basin catalog compaction enable my-bucket --target-size 128 --token $R2_CATALOG_TOKENpnpm wrangler basin catalog compaction enable my-bucket --target-size 128 --token $R2_CATALOG_TOKEN为特定表启用压缩:
npx wrangler basin catalog compaction enable my-bucket my-namespace my-table --target-size 256yarn wrangler basin catalog compaction enable my-bucket my-namespace my-table --target-size 256pnpm wrangler basin catalog compaction enable my-bucket my-namespace my-table --target-size 256禁用 catalog 级压缩:
npx wrangler basin catalog compaction disable my-bucketyarn wrangler basin catalog compaction disable my-bucketpnpm wrangler basin catalog compaction disable my-bucket为特定表禁用压缩:
npx wrangler basin catalog compaction disable my-bucket my-namespace my-tableyarn wrangler basin catalog compaction disable my-bucket my-namespace my-tablepnpm wrangler basin catalog compaction disable my-bucket my-namespace my-table有关管理压缩的更多详情,请参阅管理 catalog。
您可以配置压缩的目标文件大小。目前,最小为 64 MB,最大为 512 MB。
不同的计算引擎有不同的最佳文件大小,请查阅其文档。
性能权衡取决于您的用例。例如,返回少量数据的查询可能在小文件上表现更好,因为大文件可能导致读取不必要的数据。
- 对于延迟敏感的工作负载,考虑较小的目标文件大小(例如 64 MB - 128 MB)
- 对于流式摄取工作负载,考虑中等文件大小(例如 128 MB - 256 MB)
- 对于需要扫描大量数据的 OLAP 风格查询,考虑较大的文件大小(例如 256 MB - 512 MB)
对 Iceberg 表的每次写入(无论是插入、更新还是删除)都会创建新快照。随着时间推移,这些快照可能累积并导致性能问题:
- 元数据开销:每个快照都会在表的元数据文件中添加条目。随着快照数量增长,元数据文件变大,查询规划和表操作变慢
- 存储成本增加:旧快照引用可能不再需要的的数据文件。没有快照过期,这些文件会继续消耗不必要的存储空间
- 表操作变慢:列出快照或访问表历史等操作会随时间变慢
快照过期使用两个参数来确定要删除哪些快照:
--older-than-days:删除超过此天数的快照(默认:30 天)--retain-last:始终保留的最近快照的最小数量(默认:5 个快照)
两个条件都必须满足才会过期快照。这确保即使快照超过年龄阈值,您也始终保留最近的快照。
为 catalog 启用快照过期。此示例至少保留 10 个快照,并过期超过七天的快照:
npx wrangler basin catalog snapshot-expiration enable my-bucket --token $R2_CATALOG_TOKEN --older-than-days 7 --retain-last 10yarn wrangler basin catalog snapshot-expiration enable my-bucket --token $R2_CATALOG_TOKEN --older-than-days 7 --retain-last 10pnpm wrangler basin catalog snapshot-expiration enable my-bucket --token $R2_CATALOG_TOKEN --older-than-days 7 --retain-last 10为表启用快照过期。此示例至少保留五个快照,并过期超过两天的快照:
npx wrangler basin catalog snapshot-expiration enable my-bucket my-namespace my-table --token $R2_CATALOG_TOKEN --older-than-days 2 --retain-last 5yarn wrangler basin catalog snapshot-expiration enable my-bucket my-namespace my-table --token $R2_CATALOG_TOKEN --older-than-days 2 --retain-last 5pnpm wrangler basin catalog snapshot-expiration enable my-bucket my-namespace my-table --token $R2_CATALOG_TOKEN --older-than-days 2 --retain-last 5为 catalog 禁用快照过期:
npx wrangler basin catalog snapshot-expiration disable my-bucketyarn wrangler basin catalog snapshot-expiration disable my-bucketpnpm wrangler basin catalog snapshot-expiration disable my-bucket不同的工作负载需要不同的快照保留策略:
- 开发/测试表:较短保留期(2-7 天,5 个快照)以最小化存储成本
- 生产分析表:中等保留期(7-30 天,10-20 个快照)用于调试和分析
- 合规/审计表:较长保留期(30-90 天,50+ 个快照)以满足监管要求
- 高频摄取:更高的最小快照数量以保留更细粒度的历史记录
这些是通用建议,请务必考虑:
- 时间旅行需求
- 合规要求
- 存储成本
- 压缩目前仅支持以 parquet 格式存储的数据文件。
- 之前未被快照引用的文件不会被清理(孤立文件)。
- 压缩的最小目标文件大小为 64 MB,最大为 512 MB。